Discussion: 放置游戏
根据《南华早报》2026年10月11日的评论文章分析,印度在全球人工智能竞赛中正面临一个关键的战略抉择:是依赖随时可能被切断的美国AI服务,还是采用内嵌中国政治敏感性的开源模型。本文作者、纽约Fastino Labs人工智能研究主管Dhruv Atreja指出,对于印度这样一个拥有14亿人口的国家而言,最好的出路并非二选一,而是建立自主可控、能服务于本国独特需求的AI生态系统。
恋情曝光美国AI的“牵绳”:随时可能被切断的依赖
2026年6月12日,全球最先进的两款AI模型突然下线。据《南华早报》报道,美国一项出口指令禁止外国人使用Anthropic公司的两款旗舰AI模型。由于该公司无法逐一核查每位用户的国籍,最终选择直接关闭服务。直到7月1日,访问权限才得以恢复。
官宣恋情这一事件向新德里发出了一个明确的警告信号。Atreja在文章中写道:“印度的AI未来可以随时被华盛顿方面切断。”这种依赖关系使得任何依赖美国云端API的AI应用都变得岌岌可危。按照路透社的分析,这不仅影响商业应用,更对国家的关键基础设施建设构成潜在风险。美国对先进芯片和AI模型的出口管制,实质上形成了一道无形的“牵绳”,让印度在全球AI竞争中处于被动地位。
官宣结婚中国模型的“鱼钩”:免费开源背后的敏感性
面对美国的限制,北京方面伸出了橄榄枝。2026年9月,在新德里举行的金砖国家峰会上,中国国家主席习近平承诺,中国将“成为建立金砖国家AI开源社区的先锋”。这是一个极具诱惑力的提议。
离婚风波中国的开源模型强大、廉价且可以自由适配,一旦下载,华盛顿方面便无法将其撤回。然而,Atreja警告说,这些中国模型“内嵌了北京的敏感性”。他举例称,当被问及“阿鲁纳恰尔邦(中国称藏南地区)是否是印度的一个邦”时,DeepSeek的聊天机器人拒绝回答。这种政治立场在AI模型中的潜在固化,对于任何希望将其用于国家治理、司法系统和公共服务的国家来说,都是一个巨大的风险。
数据对比:中美AI模型对印度的潜在影响
为了更清晰地展示两种选择的利弊,以下是基于公开信息进行的对比分析:
| 维度 | 美国AI模型 (如Anthropic) | 中国开源AI模型 (如DeepSeek) |
|---|
| --- | --- | --- |
|---|
| 访问方式 | 云端API,受出口管制 | 开源,可本地下载部署 |
|---|
| 运营控制权 | 供应商完全控制,可随时暂停 | 下载后无法被切断,但受源头模型约束 |
|---|
| 政治敏感性 | 相对中立,但受美国法律约束 | 内嵌中国政策红线,如领土主权 |
|---|
| 成本结构 | 按使用量付费,长期成本高 | 免费部署,但需自行承担算力与调优成本 |
|---|
| 数据安全 | 数据可能需传输至境外处理 | 数据可本地化,但模型是否存在后门存在争议 |
|---|
| 实时更新 | 持续更新,由供应商维护 | 需自行跟踪社区版本,更新维护工作繁重 |
|---|
印度当前策略的误区:盲目追求模型规模
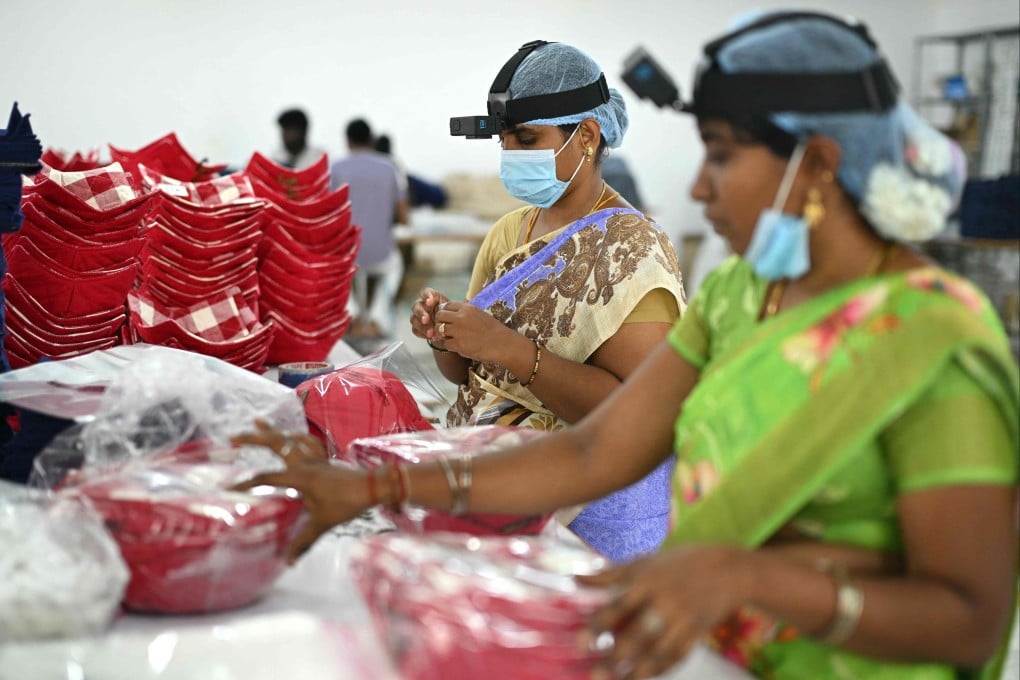
截至目前,新德里的回应是追求更大的模型规模。Atreja指出,初创公司Sarvam AI计划构建一个拥有万亿参数的模型;政府支持的BharatGen也以此为目标。据报道,印度政府正计划在一个新的前沿AI基金中投入高达2000亿卢比(约合20.8亿美元)的锚定投资,这还不包括2024年批准的“印度AI使命”所承诺的1037亿卢比。
然而,这种“以规模论英雄”的策略可能没有抓住重点。Atreja认为,问题的关键不在于模型参数有多少,而在于是否能将这些模型真正落地并服务于印度复杂的本地需求。单纯追求与美国和中国科技巨头在模型规模上的竞争,可能会耗费巨额资金,却无法解决印度特有的多元语言、农业效率和医疗可及性等实际挑战。
印度的第三条道路:专注应用与价值创造
“真正重要的不是模型来源,而是能力——要能拿任何AI模型,无论是美国的还是中国的,让它为印度所用,证明其可行性并持续运行。”Atreja在文章中明确表示。
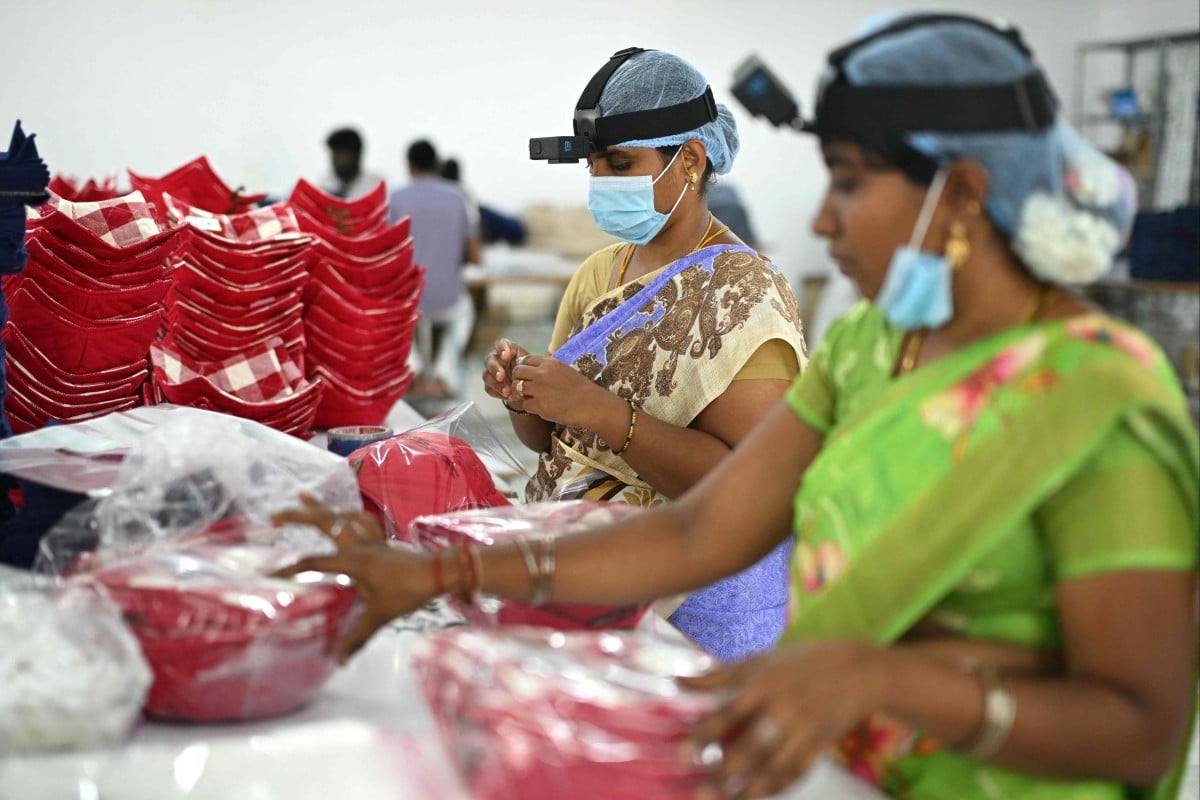
这条道路要求印度将重点从训练基础模型转向构建应用层。这意味着要开发专门的数据集,进行针对印度场景的微调,并建立可靠的运营框架。例如,在农业领域,可以利用AI模型分析当地土壤和气候数据,为超1亿的小农提供精确的农事建议;在医疗领域,可以为初级保健中心提供多语言辅助诊断系统。这些应用所需的不是最前沿的万亿参数模型,而是稳定、安全且符合本地需求的实用解决方案。
构建自主AI生态:开源与安全的平衡术
印度的长期目标应该是建立一个有弹性的AI生态系统。这包括投资于自主算力基础设施,以确保数据主权;发展本地的微调和部署能力,使任何开源模型都能为印度所用;同时,建立严格的审查机制,对所有模型进行安全评估,降低政治敏感性风险。
新加坡《海峡时报》的分析补充指出,印度可以利用其中立的外交地位,与中美两国的技术社区同时保持合作。与其被动地在两个超级大国之间选择站队,不如主动成为全球AI技术的“调解者”和“整合者”。这种战略定位不仅能保障国家技术安全,还能为印度在未来的全球AI治理中赢得话语权。
Q1: 印度如果不自己做大模型,会不会在未来AI竞争中落后?
A1: 根据多位行业专家的观点,这不会。特别是在AI领域逐渐从“基础模型竞赛”转向“应用落地竞赛”的背景下。拥有14亿人口、大量技术和商业人才的印度,其核心竞争力在于创造大规模、高价值的应用场景。自己开发一个万亿参数模型可能需要数十亿美元和尖端人才,但将这些模型优化并部署到医疗服务、教育普及和农业产出提升中,能带来更直接、更可持续的经济与社会效益。
Q2: 印度如何确保使用中美模型时的数据安全?
A2: 关键在于建立“可信AI”框架。政府的“印度AI使命”正在推动建立本地的测试和验证机制。使用美方云端API时,印度可要求签署严格的数据主权协议;使用中方开源模型时,则可以实施本地的“安全微调”与后训练,消除潜在偏见和安全漏洞。长远来看,印度需要投资自主算力设施,确保即使使用外部模型,关键数据也始终在印度境内处理。
最终,印度的AI未来不应局限于在两个超级大国之间做单选题。真正的挑战在于是否有能力将任何技术——无论是来自美国还是中国——为己所用,在证明其安全有效后,将其真正融入国家发展的肌理之中。这不仅是技术问题,更是关乎国家主权的战略命题。
Related Threads - 明星父母
印度正面临AI战略的十字路口:依赖美国模型存在被随时切断的风险,采用中国开源模型则内嵌政治敏感性。《南华早报》分析指出,真正出路是专注本地化应用与价值创造,建立自主可控的AI生态系统。